Как нейросеть создаёт видео по текстовому описанию
Если коротко, нейросеть сначала переводит описание в числа, а потом берёт ролик из чистого шума. Шаг за шагом она снимает с него лишнее, на каждом шаге сверяясь с текстом, и делает это сразу во всех кадрах — поэтому герой не теряется между секундами.
Проверить своё описаниеРезультат за минуту · Есть бесплатные шаблоны
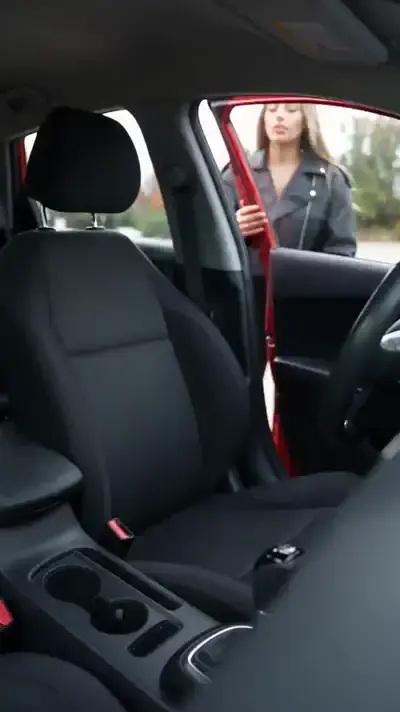
Дальше то же самое медленнее: что модель берёт из слов и что пропускает, почему ролик длится секунды, откуда звук. Пример рядом — шаблон «Девушка и паук в машине»: его описание расписано по секундам, вплоть до одного прохода дворника по стеклу.
Что модель вычитывает из текста
Текстовый кодировщик режет описание на токены — куски слов — и переводит их в векторы, где близкие по смыслу слова лежат рядом. Увереннее всего модель читает существительные и глаголы: кто, что делает, где. Точное число предметов и запреты даются ей хуже, поэтому в шаблоне с пауком нежелательное собрано отдельным списком: «несколько пауков», «больше одного прохода дворника».
Из шума в кадр
Видео не рисуется кадр за кадром, как мультфильм. Модель работает в сжатом пространстве, где ролик занимает в десятки раз меньше места, чем в пикселях. Старт — чистый шум; на каждом шаге сеть угадывает, какая его часть лишняя, и убирает её, сверяясь с текстом. В конце декодер разворачивает результат в кадры. Новый запуск — новый шум, и одно описание даёт другой ролик.
Как кадры держатся друг за друга
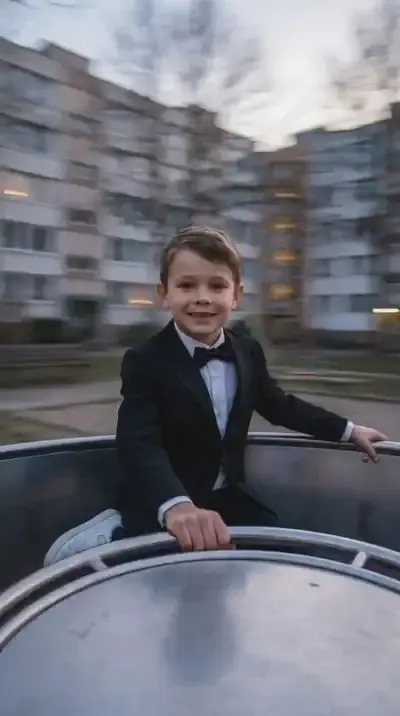
Очищаются все кадры вместе, и каждый участок картинки сверяется с соседними во времени. Так лицо, одежда и свет доживают от первой секунды до последней, а в «Катании на карусели» фон крутится, пока герой неподвижен. Цена — память: с длиной таких связей всё больше. Отсюда 5–15 секунд у большинства моделей и до тридцати у Seedance 2.5 Omni, Wan 3.0 и Kling 4.0.
Откуда в ролике звук
Звук — отдельная дорожка, и строит её не каждая модель. Seedance 2.5 Omni, VEO 3.1 и MiniMax H3 создают её вместе с картинкой, поэтому хлопок двери попадает в свой кадр. У Kling 3.0 и Wan 3.0 звук включается переключателем, модель МаркетВидео отдаёт немой ролик. Реплику модель произносит, если та стоит в описании в кавычках, как «поиграем?» в шаблоне «С игральными картами».
Проверить на себе: одно описание, три модели
Напишите сцену в две-три фразы и запустите её трижды. Модель МаркетВидео возьмёт две звезды за шесть секунд в 480p без звука, Seedance 2 Mini — шесть за пять секунд со звуком, Kling 3.0 в режиме Standard — столько же за пять секунд в 720p. Сравните, кто удержал действие из конца фразы, кто сам выбрал камеру и чей звук совпал с картинкой.
Готовые шаблоны
Частые вопросы
Какая нейросеть создаёт видео по текстовому описанию?
В форме генерации режим «Текст в видео» есть у Seedance, Kling, Wan 3.0, VEO 3.1, MiniMax H3 и модели МаркетВидео. Они различаются длиной ролика, звуком и ценой — её форма показывает до запуска.
Зачем шаблонам фото, если видео строится по тексту?
Текст шаблона уже описывает место, действие, камеру и звук, а внешность героя без снимка модель придумала бы сама. Фото ставит в ролик вас, и новый запуск сохраняет того же человека.
Можно ли посмотреть, как это работает, бесплатно?
Стартовый бонус аккаунта — пять звёзд, а шесть секунд в 480p на модели МаркетВидео стоят две. Запустите один текст дважды и увидите, как новый шум меняет ролик при тех же словах.