Как нейросеть создаёт изображение по текстовому описанию
Коротко: нейросеть переводит ваше описание в ряд чисел, кодирующих смысл, затем берёт кадр, целиком залитый случайным шумом, и за несколько десятков шагов убирает шум в сторону этого смысла. Декодер превращает результат в пиксели, а на последнем этапе картинка увеличивается до выбранного разрешения.
Создать изображение по описаниюРезультат за минуту · Есть бесплатные шаблоны
Дальше каждый этап разобран на работах каталога: какие слова модель слышит, а какие пропускает, почему проявка похожа на фотолабораторию, где граница между послушной и пластиковой картинкой и почему при одном и том же тексте выходят разные изображения.
Описание превращается в числа
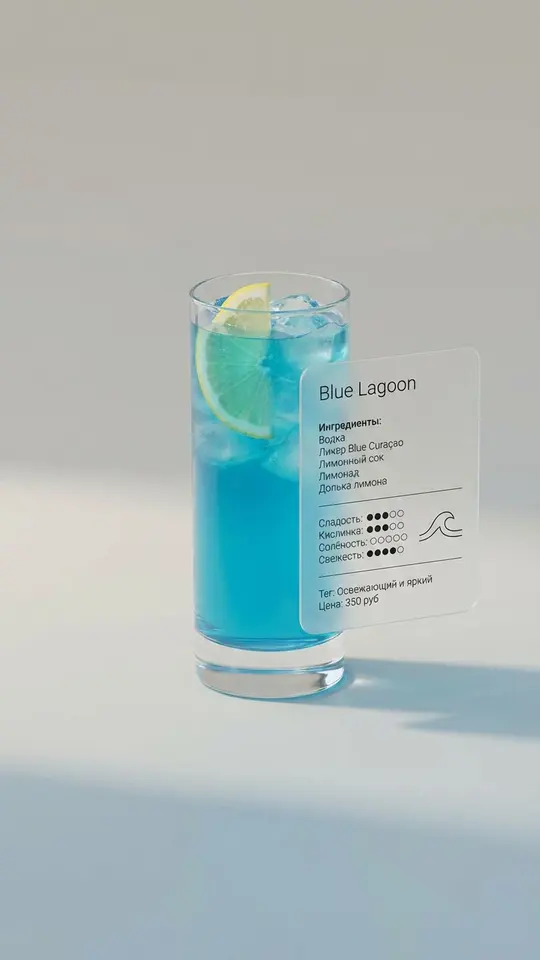
Текстовый энкодер не читает фразу как человек: он раскладывает её на смысловые признаки, где «тушь» и «штриховка» лежат рядом, а «фотография» далеко. Поэтому предметы и действия весят больше оценочных слов, а грамматика слышна слабо: «кот на столе» и «стол на коте» почти сливаются. Карточка коктейльного меню собрана как список — бокал, лёд, табличка, состав, — и каждый пункт попал в кадр.
Из шума к картинке
Старт — холст из случайных точек, в котором нет ничего. На каждом шаге модель предсказывает, какая часть шума лишняя для вашего описания, и снимает её — десятки раз, как проявка отпечатка в ванночке. В «Ботанической иллюстрации тушью» первыми проступают пятна цвета и силуэт, затем тонкая чёрная линия, последней — фактура бумаги. Считается не пиксель, а сжатое латентное представление.
Насколько строго модель слушает текст
Степень послушания задаётся не ползунком, а формулировками. Промт «Ботанической иллюстрации» требует «100 % иллюстрация, 0 % фотографии» и перечисляет, что сохранить, — за такой список модель держится крепко. Чересчур жёсткий текст даёт пластик: пересушенный контраст, плакатные цвета; слишком свободный — чужую картинку. GPT Image 2.5 исполняет условия по пунктам, NanoBanana 2.1 лучше читает сцену.
Почему один текст даёт разные картинки
Разные картинки по одному тексту — следствие стартового шума: каждый проход начинается с нового набора случайных точек, их номер называют seed. Что текстом не задано — фон, время дня, одежда, — модель придумывает заново. Номер seed в форме не задаётся, поэтому похожие варианты получают иначе: держат текст и правят одну фразу или загружают удачную картинку как референс для следующего прохода.
Где модель ошибается и почему
Руки, надписи и счёт — три слабости, и все они следуют из устройства. Энкодер хранит смысл слова, а не написание, поэтому надпись выходит узором, похожим на буквы, кириллица страдает сильнее латиницы. Количество модель слышит как «несколько»: семь яблок становятся шестью. Пальцы — десяток одинаковых тонких форм, на ранних шагах они одно пятно, которое потом делится на глаз.
Готовые шаблоны
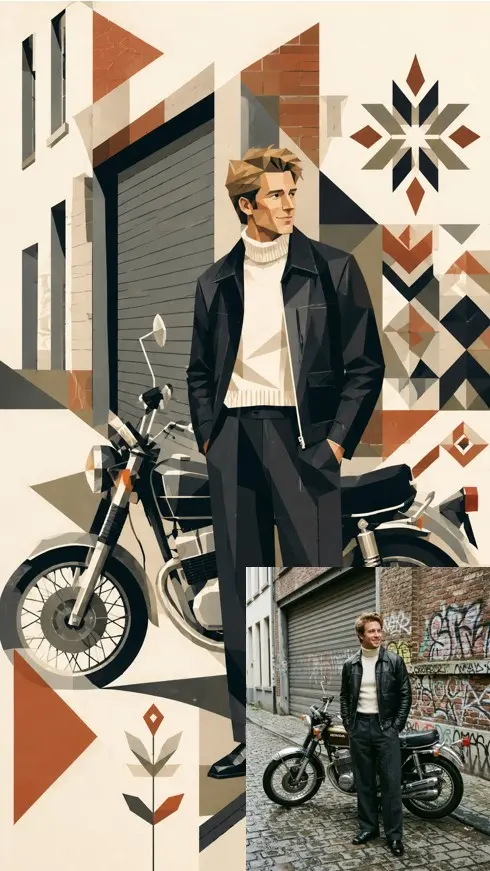
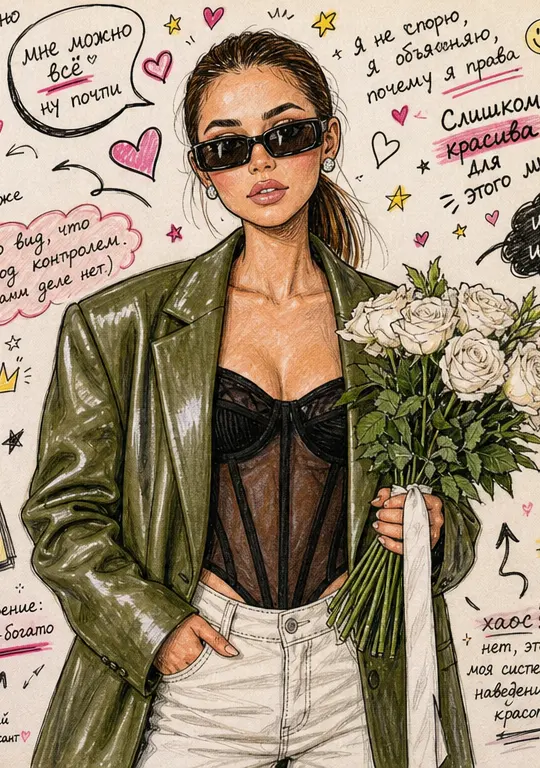
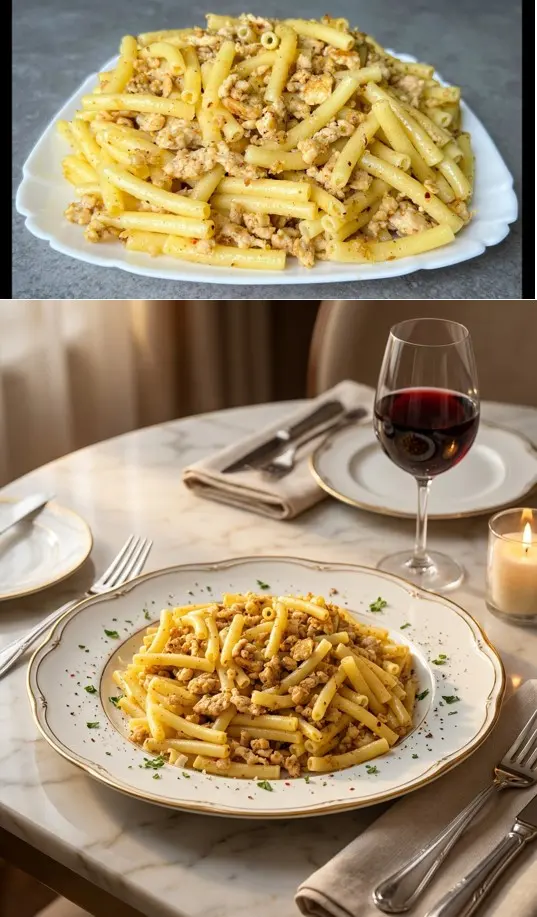
Частые вопросы
Нейросеть берёт готовые картинки из интернета?
Нет. В момент генерации у неё нет доступа к сети и ничьи файлы не склеиваются: изображение каждый раз строится из шума. Как выглядят тушь, акварель или ресторанная подача, модель усвоила при обучении, поэтому способна нарисовать то, чего никто не снимал и не рисовал.
Понимает ли нейросеть русский и сколько ждать картинку?
Описание на русском уходит в модель без перевода, и все модели формы его принимают; английские термины помогают, когда важно точное название техники. Картинка в 1K готова, как правило, меньше чем за минуту: Seedream 4.5 берёт за неё одну звезду, NanoBanana 2.1 и GPT Image 2.5 — две, а 4K у них стоит четыре.
Можно ли повторить понравившийся результат точь-в-точь?
Точной копии не будет: стартовый шум меняется, а задать его номер в форме нельзя. Близкий вариант получают двумя способами — не трогать текст и поправить одну деталь или загрузить готовую картинку референсом и описать только изменения. Так же устроена генерация по своему фото, где снимок удерживает лицо и композицию.